从零开始的LLM 12. 压缩算法 (RMT 和 RCC)
前言
本文将介绍 token压缩技术的原理。
• Recurrent Memory Transformer (RMT)
• Recurrent Context Compression (RCC)
经过前面的学习,我们已经系统地完成了大语言模型(LLM)的基础部分,主要参考了以下资料:
- 《动手学深度学习》
- 《蘑菇书》
- 《Happy-LLM》
- 《Hello-Agents》
- 《all-in-rag》
到这里,可以认为已经具备了继续深入学习 Agent 的基础能力。
接下来的内容将不再像之前那样按照固定课程循序渐进,而是更多围绕当前 Agent 领域的研究方向展开。学习内容既会涉及工程实践(如各种 Agent 框架、工作流、记忆系统等),也会涉及算法与模型层面的探索(如多模态、持续学习等)。
- Generative Agents
- Letta
- A-MEM
- Voyager
这条路线主要围绕 Agent 的持续学习(Continual Learning) 展开,也是我目前最感兴趣的方向:如何让一个 Agent 在长期运行过程中不断积累经验、提升能力,而不是每次都从零开始。
目前来看,大致有两种思路:
- 不修改模型本身。 仅通过 Prompt、记忆系统(Memory)、RAG、工具调用等机制,使 Agent 能够不断积累知识和经验,实现能力的持续增长。
- 修改模型本身。 基于 Agent 长期运行过程中积累的对话、笔记和总结等数据,在合适的时机对模型进行持续训练(Continual Fine-tuning),使模型真正将这些经验内化,而不仅仅依赖外部记忆。
由于这一阶段更多是阅读论文、分析开源项目、验证实验以及整理个人理解,而不是单纯跟着教程学习,因此资料收集、实验和整理都会比之前花费更多时间。
1. 前景提要
为什么要学压缩技术呢,主要是我在开发《杀戮尖塔》游戏agent的时候遇到了问题。
我希望使智能体能够自主理解游戏规则并完成通关。目前已实现游戏交互的
Python 脚本(在游戏内开启 Web 服务,通过 REST API
获取状态并执行动作,例如 GET /state
获取当前状态,POST /doAction
执行指令)。在逐步构建智能体的过程中,遇到诸多挑战,因此重新规划了阶段性方案:
- 第一阶段:基础智能体(基于 React 的 LLM + 短期/长期记忆),已完成并保存,作为无附加功能的基线。
- 后续多智能体协作流程:
- 交互智能体:接收用户输入,与游戏进行交互。
- 观察智能体:分析交互记录(用户输入、工具调用及结果),提取基础事实(如"打击造成 6 点伤害""对易伤目标造成 9 点伤害""易伤增伤 50%"等),并存储至临时文件。
- 整合智能体:梳理临时文件中的信息,合并整理到最终知识库。
- 内化智能体:基于知识库分类生成训练数据,并通过蒸馏将知识融入基础智能体。
然而,实践中暴露出关键问题:2. 观察智能体会重复提取相同的知识(例如每次战斗状态均会分析出"打击造成 6 点伤害"),导致大量冗余信息。
若每次从记忆或 RAG 中检索已有知识并放入提示词,既不可扩展又占用大量上下文;
若生成后再过滤,则效率低下且浪费 Token。
这里引出一个问题:智能体是否能自主"记住"已记录的事实?
答案是否定的——LLM 在推理时是无状态的,每次调用完全独立,不具备持久记忆能力。所谓的记忆仅依赖于提示词中的显式上下文,无法内化于模型参数中。
因此,关于记忆的问题,我认为不可能依赖外部结构解决,必须重新审视 LLM 本身。
在此之前,我曾设想过一种方案:在每次查询(Query)前面添加若干个固定位置的向量作为"记忆槽",将历史对话内容通过编码器(Encoder)模型压缩成紧凑的向量表示,塞入这些记忆槽中(之所以选择 Encoder 而非 Decoder,是因为 Decoder 模型的压缩能力集中在最后一个 Token 上,承载量实在太小,难以容纳完整的对话信息)。
后来,我又想到了蒸馏的方法——这个思路一开始是我自己独立提出的,后续进一步调查时发现已有类似工作。蒸馏能够将知识内化到模型参数中,听起来能从根本上解决问题,因此我暂时搁置了压缩记忆槽的设想,转而尝试通过蒸馏实现知识内化。
但实践下来,蒸馏遇到了新的瓶颈:知识本身具有完整的陈述结构,可以基于此构造训练数据集进行内化;然而"记忆"本质上仅仅是对发生过的事实的"记得",它缺乏明确的结构化表达,极其难以构造合理的训练数据集。因此,我重新评估后认为,最初考虑的压缩算法反而更契合记忆任务的需求。
基于上述思考,我目前正在重新系统性地研究循环记忆变换器(Recurrent Memory Transformer, RMT)和循环上下文压缩(Recurrent Context Compression, RCC)等相关技术,探索如何在 LLM 推理过程中以紧凑、可更新的方式集成长期记忆。
2. Recurrent Memory Transformer (RMT)
2.1 原理
这个方法并不会改变 Transformer 模型结构本身。只对输出和输入部分进行修改。
首先看论文中的流程图
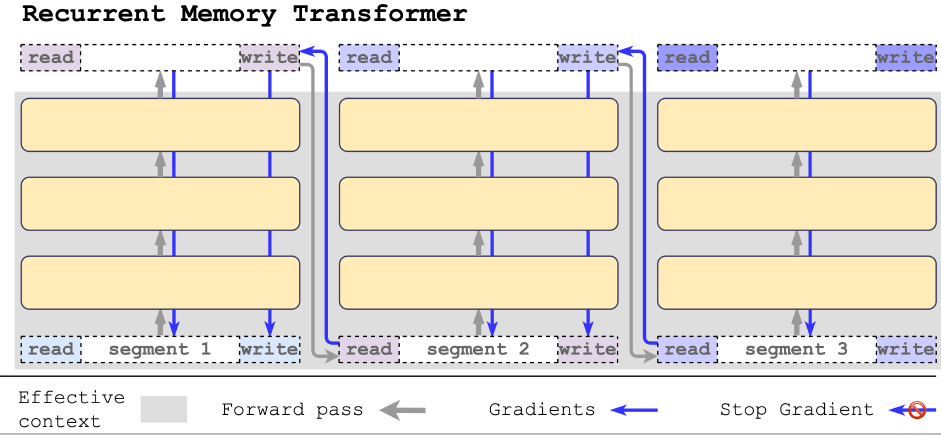
首先,RMT会将一段长的token切分成多个块,命名为segment。在每个segment前后添加数个token,作为memory使用(即图中的read和write部分)
我们举例说明,
假设存在 token : [A] [B] [C] ... [Z] 在一个segment中。
在 原token序列的前后方添加上memory token,组成完整的input:[MEM1] [MEM2] [A] [B] [C] ... [Z] [MEM3] [MEM4]
[MEM1] [MEM2] 和 [MEM3] [MEM4] 分别代表图中的read 和 write部分,这里我仅用两个token表示。
普通词token通过embedding变成向量,然后进入LLM的transformer进行计算。
但是input中的read和write部分,一开始就是一个可学习的向量参数(
nn.Parameter(torch.randn(num_mem_tokens, hidden_dim))。因此实际拼接是在都变成向量后进行的。在同一次前向传播(处理一整条长序列的所有segment)中:
- 第一个segment的input,read部分和write部分都使用这套可学习参数当前的值(不是随机初始化——随机初始化只发生在模型刚创建、还没开始训练的那一刻;训练过程中的每一步用的都是截至目前已经学到的参数值)。
- 从第二个segment开始,read部分的输入被替换为上一个segment计算完成后、write位置产生的输出(即压缩后的记忆内容);而write部分的输入,每个segment都仍然使用同一份可学习参数(在本次forward全程中,这份参数没有被更新,所以每个segment看到的write输入值都相同)。
整条序列的所有segment跑完后,把loss加总,统一执行一次反向传播(BPTT),梯度沿着"write输出→下一个segment read输入"这条链条跨越多个segment传播回去。此时,read参数(主要从segment1获得梯度)、write参数(从所有segment累积梯度)、以及Transformer本体权重,会在这次反向传播后被一起更新,用于下一次训练迭代。
虽然从第二个segment开始,read位置的输入值被替换成了上一个segment write位置的输出,但第一个segment的read部分仍然用的是那份可学习的"初始read参数",因此read的向量会从segment1的loss里拿到梯度并被更新。
input 在经过 Transformer 模型的计算后,在每个位置生成对应的输出,[MEM3] [MEM4] 所在位置的输出结果,则是该segment信息内容的压缩。
在计算组装下一个segment的input时,将此时输出的write部分内容放在本次input的read部分位置,作为压缩的上下文内容读入。本次input中的write部分依然仅作为占位符进行初始化。
2.2 训练
假设序列被划分为两个 Segment:
1 | Segment 1: a b c d |
不切分 Segment 时
标准 next-token prediction 是:
1 | a → b |
所以:
1 | d 的输出 → 预测 e |
切分成 Segment 后
对于 Segment 1:
1 | [a b c d] |
模型仍然按照自回归方式计算:
1 | a → b |
这里需要特别注意:
虽然 e 位于 Segment
2,但 e 作为 d
的下一个 token,仍然可以由 Segment 1 最后位置
d 的输出进行预测。
即d → e 的 loss 仍然属于 Segment 1 这一侧的计算。
对于 Segment 2 :
RMT 会将 Segment 1 产生的 memory 传递给下一段:
1 | [MEM1'] [MEM2'] [e f g h] |
此时需要注意,e 已经作为 Segment 1 中
d 的预测目标被计算过了。
即从 [MEM1'] [MEM2'] [e] 开始预测 f,g,h
因此,Segment 2 中真正继续计算的 next-token prediction 是:
1 | e → f |
Segment 切分本身不会改变 next-token prediction 的逻辑。只是把序列分块处理;跨 segment 的预测关系仍然存在,而 RMT 用 memory 来携带跨 segment 的信息。
核心结论
Segment 切分本身不会改变 next-token prediction 的目标关系:
1 | a → b → c → d → e → f → g → h |
切分后只是将这个连续序列分成多个块进行计算。
RMT 的作用是通过 memory 将前一个 Segment 的上下文信息传递到后一个
Segment,使后一个 Segment 在处理 e f g h
时仍然能够利用前一个 Segment 的信息。
RMT 不能直接拿一个很长的文本开始训练。
根本原因在于训练稳定性和 Memory 利用的有效性。
- 训练不稳定:如果一开始就让模型处理多个 Segment,模型不仅难以学会有效利用 Memory,训练过程还可能无法收敛。消融实验表明:不使用课程学习、直接在最大 Segment 数上训练时,模型既难以学会任务,也无法很好地泛化到其他长度。
- 梯度传播困难:RMT 依赖 BPTT 沿着 Memory token 跨 Segment 反向传播梯度。Segment 数越多,BPTT 展开越深,梯度传播链路越长,因此越容易出现梯度消失或梯度爆炸的问题。
因此,原始 RMT 采用了课程学习(Curriculum Learning):
- Step 1:先从 1 个 Segment 的简单任务开始训练;
- Step 2:模型掌握后,逐步增加 Segment 数量;
- Step 3:训练后期混合不同数量的 Segment,提升模型对不同长度的泛化能力。
这种方法虽然有效,但训练流程更复杂,且计算成本较高。
3. Recurrent Context Compression (RCC)
3.1 原理
RCC 通过 encoder-decoder 架构,把长文本压缩成一组更短的向量表示,从而在有限存储空间内扩展 LLM 的有效上下文长度。
Encoder 部分:将 Segment 压缩为状态向量
Encoder 可以基于 Transformer,也可以采用类似 Mamba 的 RNN 结构。其核心思路是:将长文本切分成固定长度的 Segment,并将每个 Segment 压缩成一组状态向量。
压缩率(compression rate)表示一个压缩向量最多概括多少个 token。
例如,压缩率设为 4,表示每 4 个 token 压缩成 1 个压缩向量,因此 Segment 长度也设为 4。
假设 segment1 包含这 4 个 token:
1 | t1, t2, t3, t4 |
经过 RCC encoder(假设 3 层)逐层计算,得到每层的输出:
1 | c1_1, c1_2, c1_3, c1_4 (第1层输出) |
从每层输出中取位置为压缩率整数倍的那个向量,也就是每个 segment 的最后一个位置(这里压缩率为4,所以取第4个位置)。
因此每层取第4个位置的输出,拼接成该 segment 的压缩向量列表:
1 | C_segment1 = [ c1_4, c2_4, c3_4 ] |
之所以选择 Segment 的最后一个位置,是因为 Encoder 采用因果(causal)结构,每个位置只能看到当前位置及之前的 token。只有最后一个位置看到了整个 Segment 的全部内容,因此它的隐藏状态才能代表整段信息。
这里的encoder指的是拥有encoder功能的一个模块,即将多个token压缩成更少的token,具体实现可以使用decoder transformer模型等其他模型。
Decoder 部分:解压 / 生成
Decoder 的作用是将这些压缩信息注入 LLM,使模型在生成时能够利用原始长文本中的信息。
首先,将 prompt 全部转换为 token 向量:
1 | e1, e2, ..., en |
C_segment1
中的每个向量,先经过一个线性层,将维度映射到与 e 相同:
1 | C_segment1_linear = [ ^c1_4, ^c2_4, ^c3_4 ] |
假设 decoder 同样只有 3 层:
第一层
- 输入:将
^c1_4拼接在 token 序列前面
1 | [ ^c1_4 | e1, e2, ..., en ] |
- 输出
1 | [ h1 | o1_1, o1_2, ..., o1_n ] |
第二层
- 压缩向量对应位置的输出,通过残差连接与下一层压缩向量相加(注意:只有压缩信息对应的位置做这个更新,真实 token 部分的输出原样传递)
1 | h1_new = h1 + ^c2_4 |
- 输入
1 | [ h1_new | o1_1, o1_2, ..., o1_n ] |
- 输出
1 | [ h2 | o2_1, o2_2, ..., o2_n ] |
第三层
同样地:
1 | h2_new = h2 + ^c3_4 |
- 输入
1 | [ h2_new | o2_1, o2_2, ..., o2_n ] |
- 输出
1 | [ h3 | o3_1, o3_2, ..., o3_n ] |
若压缩向量的层数与 decoder 层数不一致,论文中说明可用简单的规则映射(复制或取平均)来对齐。
举例:压缩向量层数 ≠ decoder层数时的映射规则
假设 encoder 提取出的压缩向量有
3层:[c1, c2, c3]
情况一:decoder层数 > 压缩向量层数(用复制)
decoder 有 6层,需要把3个压缩向量"摊"到6层上,用复制的方式,每个压缩向量重复用两次:
1 | decoder第1层 ← c1 |
情况二:decoder层数 < 压缩向量层数(用平均)
decoder 只有 1层,但压缩向量有3层,此时把3层向量取平均,合并成1个向量给这一层用:
1 | decoder第1层 ← (c1 + c2 + c3) / 3 |
如果是decoder 2层、压缩向量6层这种不能整除的情况,通常也是按顺序分组后组内取平均(比如6层分成2组,每组3层取平均,分别给decoder的第1、2层)。
多个 segment 的情况
当输入包含多个 Segment 时,Decoder 的每一层都会将所有 Segment 对应该层的压缩向量并列拼接,再接上真实的 token embedding。
例如,假设有 Segment 1 和 Segment 2,则
Decoder 第一层的输入为:
1 | [^c1_4(seg1), ^c1_4(seg2) | e1, e2, ..., en] |
后续各层的结构相同,只需将压缩向量替换为对应层的输出:
1 | 第 1 层: |
因此,每个 Decoder 层都会同时接收所有 Segment 在该层产生的压缩向量,并将它们与真实 token 一起输入 Decoder。
自回归生成
生成时的整体流程分为两个阶段:
第一阶段:历史内容压缩(encoder)
之前的对话历史,提前经过 encoder 处理,按 segment
切分并逐层压缩,得到对应的一组压缩向量
^c_layer(seg1), ^c_layer(seg2), ...。这一步和当前 prompt
无关,是提前准备好的历史信息摘要。
第二阶段:拼接压缩向量 + prompt,进行生成(decoder)
当前用户输入的 prompt,转换成正常的 token embedding
e1, e2, ..., en,不经过压缩。
decoder 按照之前描述的流程,把 encoder 准备好的
^c_layer(seg) 放在每一层输入的前面,接上 prompt 的
token:
1 | [ ^c_layer(seg1), ^c_layer(seg2), ... | e1, e2, ..., en ] |
在 prompt token 之后,decoder 按标准自回归 next-token prediction 的方式,逐步生成下一个词、再把新生成的词接到序列末尾、继续预测下一个词,如此循环,直到生成结束。
RCC 的本质:扩展而非无限压缩
RCC 与 RMT 的核心区别之一在于:RMT 通过 Memory 在 Segment 之间递归传递信息,理论上可以持续处理任意长度的序列;而 RCC 并没有彻底消除 Decoder 的上下文长度限制。
RCC 的本质是扩展 Decoder 能够利用的有效上下文长度,而不是无限扩大上下文窗口。
这一点可以从论文给出的公式看出:
RCC 理论最大上下文长度 = Encoder 压缩率 × Decoder 上下文窗口长度
也就是说,Decoder 本身的上下文窗口仍然是有限的。区别在于,原本一个位置只能容纳一个原始 token,而经过压缩后,一个位置可以表示多个原始 token。
因此,压缩率越高,同样大小的 Decoder 窗口能够覆盖的原始文本越长。但这种扩展本质上仍然是一个乘法关系;当输入超过理论最大长度后,RCC 依然无法继续利用更早的上下文。
同时,压缩率与信息保真度之间存在明显的 trade-off:
压缩率越高 → 每个压缩向量需要概括的 token 越多 → 信息密度越高 → 信息损失也越大。
论文实验中,即使在 32 倍压缩率下,文本重建任务的 BLEU-4 仍接近 0.95,说明 RCC 在较高压缩率下依然能够较好地保留信息。但这并不意味着压缩率越高越好;继续提高压缩率后,单个压缩向量需要承载的信息越来越多,重建和利用这些信息时的失真也会更加明显。
因此,RCC 更准确的定位是:
通过可控的信息损失,换取更长的有效上下文。
它是在上下文长度与信息保真度之间进行权衡,而不是像 RMT 那样通过跨 Segment 的递归 Memory 机制,从架构层面绕开固定上下文窗口的限制。
4. 总结
RMT
RMT 在架构层面可以通过 Memory 在 Segment 之间递归传递信息,因此理论上可以持续处理任意长度的序列,不受固定的总序列长度限制。但实际使用中仍存在几个重要限制:
- Memory 容量有限:每个时刻能够保留多少信息,取决于 Memory token 的数量。Memory token 越多,能够承载的信息越多,但每个 Segment 的计算量也会相应增加。由于 Memory token 的读写开销只发生在当前 Segment,因此这部分开销不会随着序列长度累积,而是每处理一个 Segment 都固定增加。
- 训练成本高、流程复杂:RMT 通常需要通过课程学习逐步增加 Segment 数量,同时依赖 BPTT(反向传播) 跨 Segment 传播梯度。当 BPTT 展开深度过大时,容易出现梯度不稳定,导致模型能够有效利用的跨 Segment 记忆深度存在实际瓶颈。
- 迁移性较差:Memory 机制需要针对具体模型进行训练。因此训练完成后,通常难以直接迁移到另一个模型(例如更大的模型),往往需要重新进行训练,训练成本较高。
RCC
RCC 虽然名称中也包含 Recurrent,但其核心思路与 RMT 不同。它本质上是通过压缩将 LLM 原本的上下文窗口等比例扩展,而不是从架构层面消除上下文长度限制:
- 长度上限依然存在:理论最大上下文长度 = 压缩率 × Decoder 上下文窗口长度。因此超过这个上限后,RCC 依然无法继续利用更早的上下文。
- 压缩率与保真度存在权衡:压缩率越高,单个压缩向量需要概括的原始 token 越多,信息损失也越大,保真度随之下降。论文中 32 倍压缩率下文本重建任务的 BLEU-4 已接近 0.95,说明较高压缩率下仍能保持较好的效果,但也说明压缩率并非越高越好。
- 核心思想:本质上是用可控的信息损失,换取更长的有效上下文。
适用场景差异
从设计动机来看,两者更适合不同类型的场景:
- RMT 更适合流式、持续增长的序列处理。例如对话历史不断增加时,可以逐段处理并通过 Memory 持续传递信息,不需要提前知道最终序列长度。
- RCC 更偏向预处理式压缩。可以提前将较长的历史内容压缩,再与当前 Prompt 一起输入 Decoder,更适合历史内容相对固定、需要基于完整历史进行一次性生成的场景。
简单来说:
RMT:通过递归 Memory 持续处理更长的序列。 RCC:通过压缩让有限的 Context Window 容纳更多原始内容。
额外资料:
| 方法 | GitHub 仓库 | 定位 / 特点 |
|---|---|---|
| RMT | booydar/recurrent-memory-transformer |
官方实现,包含基准测试,参考价值较高 |
| RMT | lucidrains/recurrent-memory-transformer-pytorch |
社区常用的 PyTorch 实现,使用较为方便(391 Stars) |
| RCC | WUHU-G/RCC_Transformer |
官方实现,提供最高 32× 压缩率的模型 |