从零开始的LLM 13.LLM模型及训练
前言
在 2.LLM模型及训练 中,我曾介绍过 Transformer 的三类主要架构。不过当时刚开始系统学习 LLM,关注点主要集中在 Decoder 结构,对 Encoder 和 Encoder-Decoder 的理解还不够深入。
最近在学习记忆压缩相关方法时,需要重新梳理 Encoder 和 Encoder-Decoder 架构,也因此发现了之前文章中一些理解上的疏漏。因此,这次重新整理并撰写这篇文章,对decoder简单介绍,着重于其他两种结构。
1. Transformer
1.1 Transformer 是什么
Transformer 是一种神经网络模型架构。我们在前文推导的 Multi-Head Attention,正是 Transformer 最核心的组成部分。一个完整的 Transformer 由 Encoder(编码器)或 Decoder(解码器),以及若干归一化层与线性层共同构成。
目前主流的 Transformer 模型分为三类:
- Encoder-Only:只理解,不生成(代表:BERT)
- Decoder-Only:以生成为核心(代表:GPT、Claude)
- Encoder-Decoder:理解后再生成(代表:T5、翻译模型)
2. Encoder-Only
在 Encoder-Only 架构中,Attentioni部分只由 Self-Attention 组成。
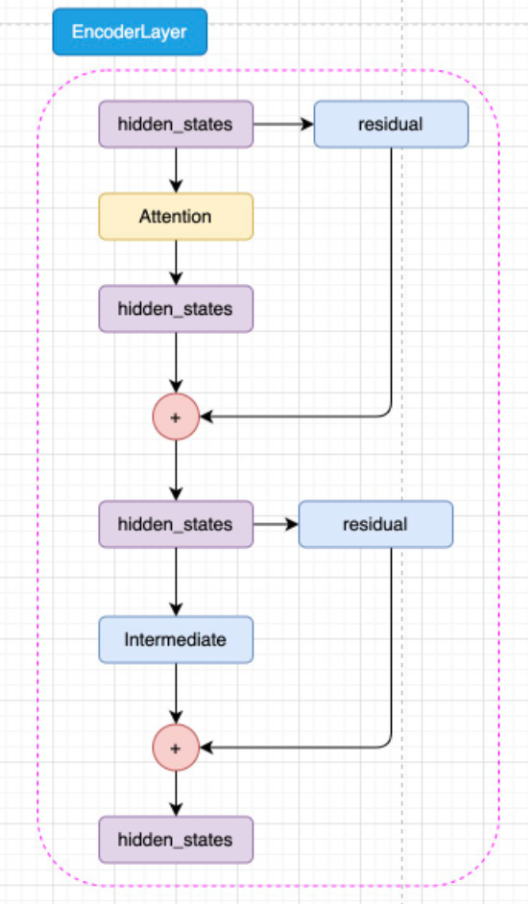
如图所示,一个 Encoder Layer 通常由两个子结构串联组成:
Self-Attention:输入首先经过 Self-Attention,让每个 token 根据其他 token 的信息更新自身的表示,然后通过残差连接(Residual Connection)与原始输入相加。
FFN(Feed-Forward Network):上一步得到的结果进入前馈网络进行进一步的非线性变换,再通过残差连接与输入相加。FFN 不会让不同 token 之间发生信息交互,而是独立地处理每个 token。经过 FFN 后,token 的数量不变,最终通过残差连接与 FFN 的输入相加。
为什么需要Attention 与 FFN 的分工?
Attention 和 FFN 在 Transformer 中承担着不同的作用。
Attention 的核心作用是信息交互。 Self-Attention 会根据 Query 和 Key 计算不同 token 之间的注意力权重,再对 Value 进行加权求和。因此,它解决的主要问题是:当前 token 应该从其他 token 获取哪些信息,以及获取多少信息。 但 Attention 本身并不能单独完成足够复杂的非线性特征变换。
FFN 的核心作用是对每个 token 的表示进行非线性变换。 它对 Attention 混合后的信息进行进一步加工,通过非线性激活函数增强模型的特征表达能力,帮助模型学习更加复杂的语法、结构和语义关系。
两者不断交替,使 Transformer 能够逐层构建更加复杂的语义表示。
2.1 预训练任务 —— MLM
BERT 主要采用 MLM(Masked Language Model,掩码语言模型)进行预训练。
MLM 可以理解为一种“完形填空”任务:在文本序列中随机选择一部分 token,将其遮蔽,然后要求模型根据上下文预测这些位置原本是什么 token。
1 | 输入: I <MASK> you because you are <MASK> |
其中,
[MASK]是 BERT 词表中专门添加的特殊 token,与[CLS]、[SEP]、[PAD]等一样,都具有固定的 token ID。
需要注意的是,并不是所有位置都参与损失计算。只有被选中的 Mask 位置,其输出才会被送入分类层,并与对应的真实 token 计算交叉熵损失:
模型实际上会为每个位置输出一个该位置的整个词表上的概率分布**,然后使用真实 token 对应的概率计算交叉熵。
Decoder-Only(如 GPT)的预训练方式不同。
Decoder-Only 通常使用 CLM(Causal Language Modeling,因果语言模型)。模型在每个位置预测下一个 token,并通过 Causal Mask 阻止当前位置看到未来 token。
在具体训练时,BERT 随机选择每条训练语料中 15% 的
token 参与预测,但这 15% 并非全部替换为
[MASK],而是按如下比例处理:
| 处理方式 | 概率 | 目的 |
|---|---|---|
替换为 [MASK] |
80% | 核心遮蔽,驱动模型预测 |
| 替换为随机 token | 10% | 迫使模型保持对全部 token 的上下文表征 |
| 保持原 token 不变 | 10% | 消除预训练与微调阶段的分布偏移 |
2.2 预训练任务 —— NSP
MLM 主要学习 token 级别的上下文关系,但一些 NLP 任务还需要理解句子之间的关系。
例如:
- 问答匹配:判断问题与回答是否匹配;
- 自然语言推理(NLI):判断一个假设是否能够由前提推出;
- 句子关系判断:判断两个句子之间是否存在特定关系。
因此,BERT 在原始论文中还引入了 NSP(Next Sentence Prediction,下一句预测)任务。
NSP 的任务非常简单:给模型两个句子,让模型判断第二个句子是否是原始文本中紧接着第一个句子的下一句。
例如:
1 | Sentence A: |
如果 B 确实是原文中 A
的下一句,则标签为:IsNext,否则:NotNext
本质上,这就是一个带标签的二分类任务。
BERT 使用 [CLS]
位置的最终隐层向量作为整个句对的表示,然后接入一个分类层。
可以简单理解为:NSP 是在 BERT 的 Encoder 输出基础之上增加一个分类任务,通过监督学习训练模型判断两个句子之间的关系。
2.3 下游任务微调
BERT 的一个重要特点是:预训练阶段和下游任务阶段可以使用统一的输入格式。
其中最重要的两个特殊 token 是:
[CLS] —— Classification Token
BERT 会在每个输入序列的开头加入 [CLS]。
经过多层 Transformer Encoder 后,[CLS] 位置的隐层向量会通过 Self-Attention 与整个输入序列进行信息交互,因此可以作为整个序列的语义表示。
例如:
1 | [CLS] 这部电影节奏紧凑,演员表演非常自然 [SEP] |
对于文本分类、句子关系判断等任务,可以直接取 [CLS]
对应的最终隐层向量,再接入一个分类器。
[SEP] —— Separator Token
[SEP] 用于表示句子的边界。
对于句对任务,两个句子可以拼接后一起输入:
1 | [CLS] Sentence A [SEP] Sentence B [SEP] |
同时,BERT 还可以使用 Segment Embedding(Token Type Embedding)区分两个句子:
1 | Sentence A → Segment A |
这样模型可以同时获得 token、位置信息以及句子所属的 Segment 信息。
常见下游任务
- 句对分类(Sentence-Pair Classification)
例如自然语言推理(NLI)、语义相似度判断等。将两个句子拼接后输入
BERT,通过 [CLS]
的最终隐层向量表示整个句对,再接入分类器得到预测结果。
- 单句分类(Single-Sentence Classification)
例如情感分析、文本分类等。输入单个句子,同样取 [CLS]
的最终隐层向量作为句子的语义表示,再接入分类器进行预测。
以情感分类为例:用 BERT 判断电影评论是正面还是负面。
第一步:准备输入
将评论按照 BERT 的输入格式进行处理:
1 | [CLS] 这部电影节奏紧凑,演员表演非常自然 [SEP] |
第二步:增加分类头
预训练好的 BERT 可以作为基础模型,将 [CLS]
位置的最终隐层向量作为输入,接入一个分类网络进行训练。
假设 BERT 的隐藏维度为 768:
1 | [CLS] hidden state |
这里的分类网络结构通常比较简单,分类任务所需的语义特征主要由 Transformer Encoder 提取。
Loss 仅根据最终的分类结果计算。反向传播时,梯度会从分类网络继续传回 Transformer Encoder,并更新其参数;与分类网络相比,Encoder 通常采用更小的学习率,以避免破坏预训练得到的语言表示。
第三步:准备训练数据
与 BERT 的预训练相比,下游任务通常只需要规模小得多的标注数据。
例如情感分类数据:
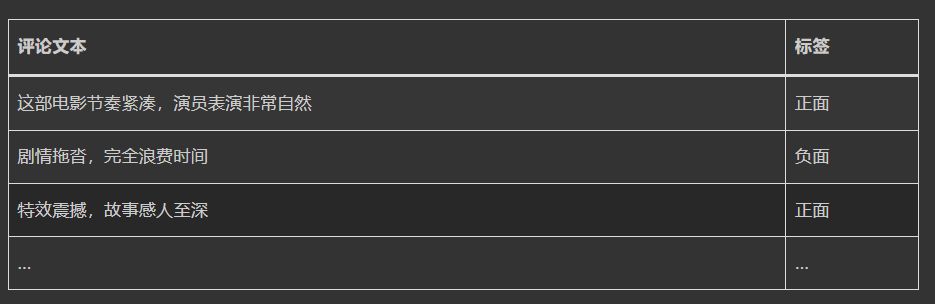
第四步:进行微调
使用这些带标签的数据训练模型。
典型情况下,会使用较小的学习率,例如 2e-5,训练若干个
Epoch。
这里需要注意:传统 BERT Fine-tuning 并不是只训练顶部的分类头,而是通常会同时更新 BERT 本体和新增的分类头。
训练过程中的梯度会从分类头向后传播,最终更新 BERT 的预训练参数,使其逐渐适应当前的下游任务。
第五步:推理
微调完成后,输入新的电影评论:
1 | [CLS] 导演的镜头语言太生硬,故事也讲不清楚 [SEP] |
模型经过 BERT Encoder 后,取 [CLS]
的隐层向量输入分类头。
模型输出:负面: 92% 正面: 8% → 预测结果:负面 ✓
3. Decoder-Only
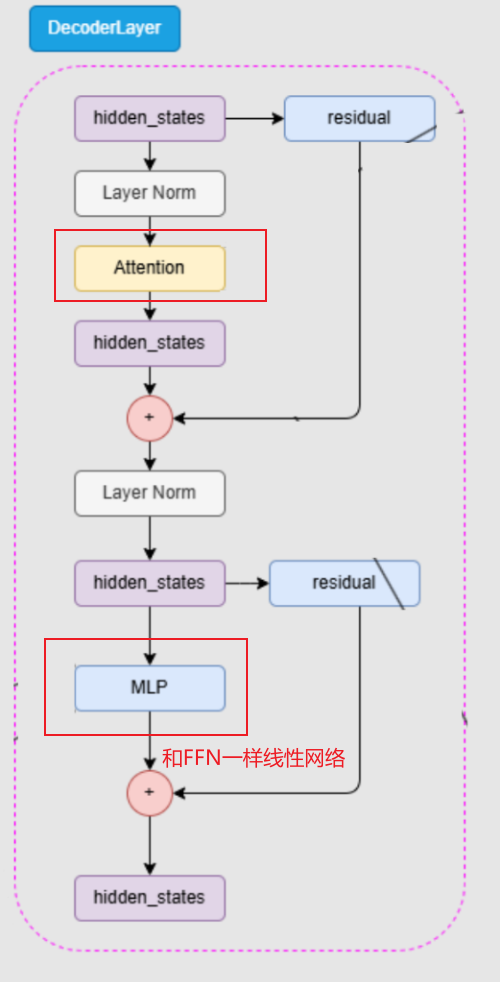
Decoder-Only 模型的 Attention 部分只使用 Masked Self-Attention。
Masked Self-Attention:每个 token 只能关注自己以及它之前的 token,无法看到后续位置的 token。这保证了自回归生成时的信息约束——模型在预测第 (i) 个 token 时,不能“偷看”第 (i+1) 个及之后的内容。
与 Encoder-Only 模型类似,Decoder Layer 在 Attention 后同样包含 FFN(通常在现代 LLM 中称为 MLP),用于对 Attention 混合后的信息进行进一步的非线性变换。
3.1 预训练任务 —— CLM
Decoder-Only 模型(如 GPT)通常采用 CLM(Causal Language Modeling,因果语言模型)进行预训练。
CLM 的核心思路是:
给定前面的所有 token,预测下一个 token。
由于使用了 Masked Self-Attention,模型在训练时无法看到当前 token 后面的内容,因此只能根据前文进行预测。
例如:
1 | 输入:今天天气 → 预测:很 |
在实际训练中,并不需要像上面的例子一样逐步输入。整个序列可以一次性输入模型,通过 Masked Self-Attention 保证每个位置只能看到自己及之前的内容,然后同时计算各个位置的预测结果。
3.2 SFT(Supervised Fine-Tuning,有监督微调)
经过预训练后,LLM 已经具备较强的语言建模能力,但此时模型学习到的主要是根据上下文预测下一个 token,并不意味着它已经很好地掌握了“按照用户指令完成任务”的能力。
因此,通常还需要通过 SFT(Supervised Fine-Tuning,有监督微调)进一步训练模型,使其学习指令遵循、问答、翻译、总结等任务。
与 BERT 等 Encoder-Only 模型的下游任务微调不同,Decoder-Only LLM 通常不会针对每一种任务单独增加一个分类头,而是仍然让模型直接生成文本。
SFT 数据格式
标准的指令数据通常包含以下字段:
1 | { |
以翻译任务为例:
1 | { |
SFT 的训练格式
为了让模型学习“根据指令生成回答”这一模式,训练时通常会将 instruction、input 和 output 按照特定的模板组织起来。
例如:
1 | \### Instruction:\n{{content}}\n\n### Response:\n |
其中的 content 即为具体的用户指令。这里的用户指令不仅指
instruction 字段,而是 instruction 和
input 的拼接,即模型可以执行的一条完整指令。
在训练过程中,模型仍然采用下一 token 预测的方式,只是训练数据从普通文本变成了“指令 → 回答”的结构。
4. encoder-decoder
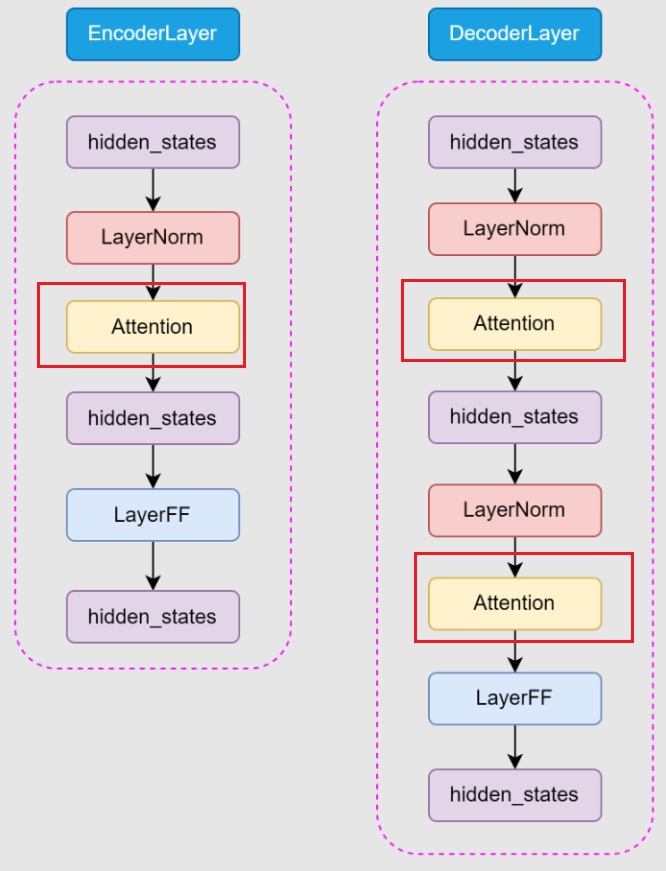
Encoder-Decoder 架构由 Encoder 和 Decoder 两部分组成。
Encoder:
每层包含 Self-Attention 和 FFN。由于没有因果掩码,Encoder 中的每个 token 都可以关注输入序列中的其他 token。
Decoder:
每层包含 Masked Self-Attention、Cross-Attention 和 FFN。
- Masked Self-Attention:对 Decoder 当前已经生成的序列进行自注意力计算,通过 Causal Mask 屏蔽未来位置,确保生成时不会看到尚未生成的 token。
- Cross-Attention:Q 来自 Decoder 当前状态,K 和 V 来自 Encoder 的输出,使 Decoder 在生成每个 token 时能够关注 Encoder 输出中的相关信息。
4.1 训练中的前向传播
Encoder-Decoder 模型需要两个输入:Encoder 输入和 Decoder 输入。
Encoder 输入是我们希望模型进行编码的内容,而 Decoder 输入则来自我们希望模型生成的目标内容。
Encoder 首先对输入序列进行 Self-Attention。由于Self-Attention中,每个位置都可以关注整个输入序列,因此 Encoder 的输出包含完整的上下文信息。
随后,Decoder 对目标序列进行处理。训练过程中,Decoder 的输入来自目标序列,但会向右移动一位,使模型在每个位置预测下一个 token。
Decoder 的输入首先经过 Masked Self-Attention,使每个位置只能看到自己以及之前的 token。
然后进入 Cross-Attention:
- Q 来自 Decoder 当前的隐层表示;
- K 和 V 来自 Encoder 的输出。
因此,Decoder 的 Masked Self-Attention 输出 在 Cross-Attention 中,可以访问 Encoder 输出中的所有 token 信息。(我们attention原理中说过,图结构是Q连向K的。)
4.2 预训练任务
T5(一个 encoder-decoder 模型)的预训练任务称为 Span Corruption。它与 BERT(encoder-only) 的 MLM 类似,但有一个关键区别:BERT 遮蔽的是单个随机 token,而 T5 遮蔽的是连续的 token 片段(Span)。
预训练的目标,是让 encoder 具备理解能力。但“理解”本身是个抽象概念,怎么定义它、怎么衡量它?
T5 的思路是:借助 decoder 来定义 encoder 的理解能力。如果 decoder 能根据 encoder 的输出,准确还原出被遮蔽的内容,就说明 encoder 真正理解了上下文。
同时,由于 loss 是从 decoder 的输出反向传播回去的,训练过程中也会顺带训练出一个能够解析 encoder 内容的 decoder。
举例说明
原始文本:The cat sat on the mat.
第一步:构造 encoder 输入。 用哨兵 token 替换掉文本中的连续片段:
1 | The <extra_id_0> on <extra_id_1> . |
经过 encoder 后,这些 token 会变成对应的 hidden vector,并作为 cross-attention 中的 K、V。
第二步:构造 decoder 输入。 decoder 需要按顺序还原每个哨兵 token 对应的内容:
1 | <extra_id_0> cat sat <extra_id_1> the mat. |
含义是:<extra_id_0> 对应 "cat
sat",<extra_id_1> 对应 "the mat"。
如果想让对应关系更明确(让看的人不产生误解),也可以改成如下作为 decoder 的输入:
1 | <extra_id_0>: cat sat \n <extra_id_1>: the mat. |
第三步:构造训练目标。 实际输入会在最前面加一个
<start> 作为起始 token:
1 | <start> <extra_id_0> cat sat <extra_id_1> the mat. |
target 则和标准的下一词训练一样,将每个词往后移一位
1 | <extra_id_0> cat sat <extra_id_1> the mat |
预测关系如下:
| 输入 | 预测目标 |
|---|---|
<start> |
<extra_id_0> |
<extra_id_0> |
cat |
| cat | sat |
| sat | <extra_id_1> |
<extra_id_1> |
the |
| the | mat |
| mat | . |
最后就是正常的 loss 计算。
4.3 微调:统一到 Text-to-Text 框架
得益于 Text-to-Text 的统一框架,T5 的微调方式非常一致:无论任务类型是什么,都只需构造对应格式的输入输出文本对,在预训练模型上继续训练即可,无需修改任何模型结构。
预训练和微调的核心差异在于 decoder
的目标:
- 预训练阶段:decoder 的目标是解释 span 里缺了什么,借此反向定义并训练 encoder 的理解能力。
- 微调阶段:decoder 的目标回归到正常的答案生成,即根据具体任务要求输出结果。
以机器翻译为例:
Encoder 输入:
1 | translate English to French: |
Decoder 输入:
1 | <start> Good morning. |
这里需要任务前缀,因为微调时模型可能需要在多个任务之间切换或训练。
然后正常地对 decoder 的输出进行下一词预测 loss 计算即可。