从零开始的LLM 11. Voyager原理学习
前言
本文将介绍 Voyager 的原理。
经过前面的学习,我们已经系统地完成了大语言模型(LLM)的基础部分,主要参考了以下资料:
- 《动手学深度学习》
- 《蘑菇书》
- 《Happy-LLM》
- 《Hello-Agents》
- 《all-in-rag》
到这里,可以认为已经具备了继续深入学习 Agent 的基础能力。
接下来的内容将不再像之前那样按照固定课程循序渐进,而是更多围绕当前 Agent 领域的研究方向展开。学习内容既会涉及工程实践(如各种 Agent 框架、工作流、记忆系统等),也会涉及算法与模型层面的探索(如多模态、持续学习等)。
- Generative Agents
- Letta
- A-MEM
- Voyager
这条路线主要围绕 Agent 的持续学习(Continual Learning) 展开,也是我目前最感兴趣的方向:如何让一个 Agent 在长期运行过程中不断积累经验、提升能力,而不是每次都从零开始。
目前来看,大致有两种思路:
- 不修改模型本身。 仅通过 Prompt、记忆系统(Memory)、RAG、工具调用等机制,使 Agent 能够不断积累知识和经验,实现能力的持续增长。
- 修改模型本身。 基于 Agent 长期运行过程中积累的对话、笔记和总结等数据,在合适的时机对模型进行持续训练(Continual Fine-tuning),使模型真正将这些经验内化,而不仅仅依赖外部记忆。
由于这一阶段更多是阅读论文、分析开源项目、验证实验以及整理个人理解,而不是单纯跟着教程学习,因此资料收集、实验和整理都会比之前花费更多时间。
1. Voyager 介绍
Voyager 是一个基于 GPT-4 的 Minecraft 开放世界探索智能体(embodied agent)。
它的核心目标并不是让 GPT-4 单纯回答 Minecraft 相关问题,而是让 GPT-4:
通过生成并执行代码,在 Minecraft 世界中自主探索、学习技能,并逐渐完成更加复杂的任务。
Voyager 的整体工作过程可以概括为:
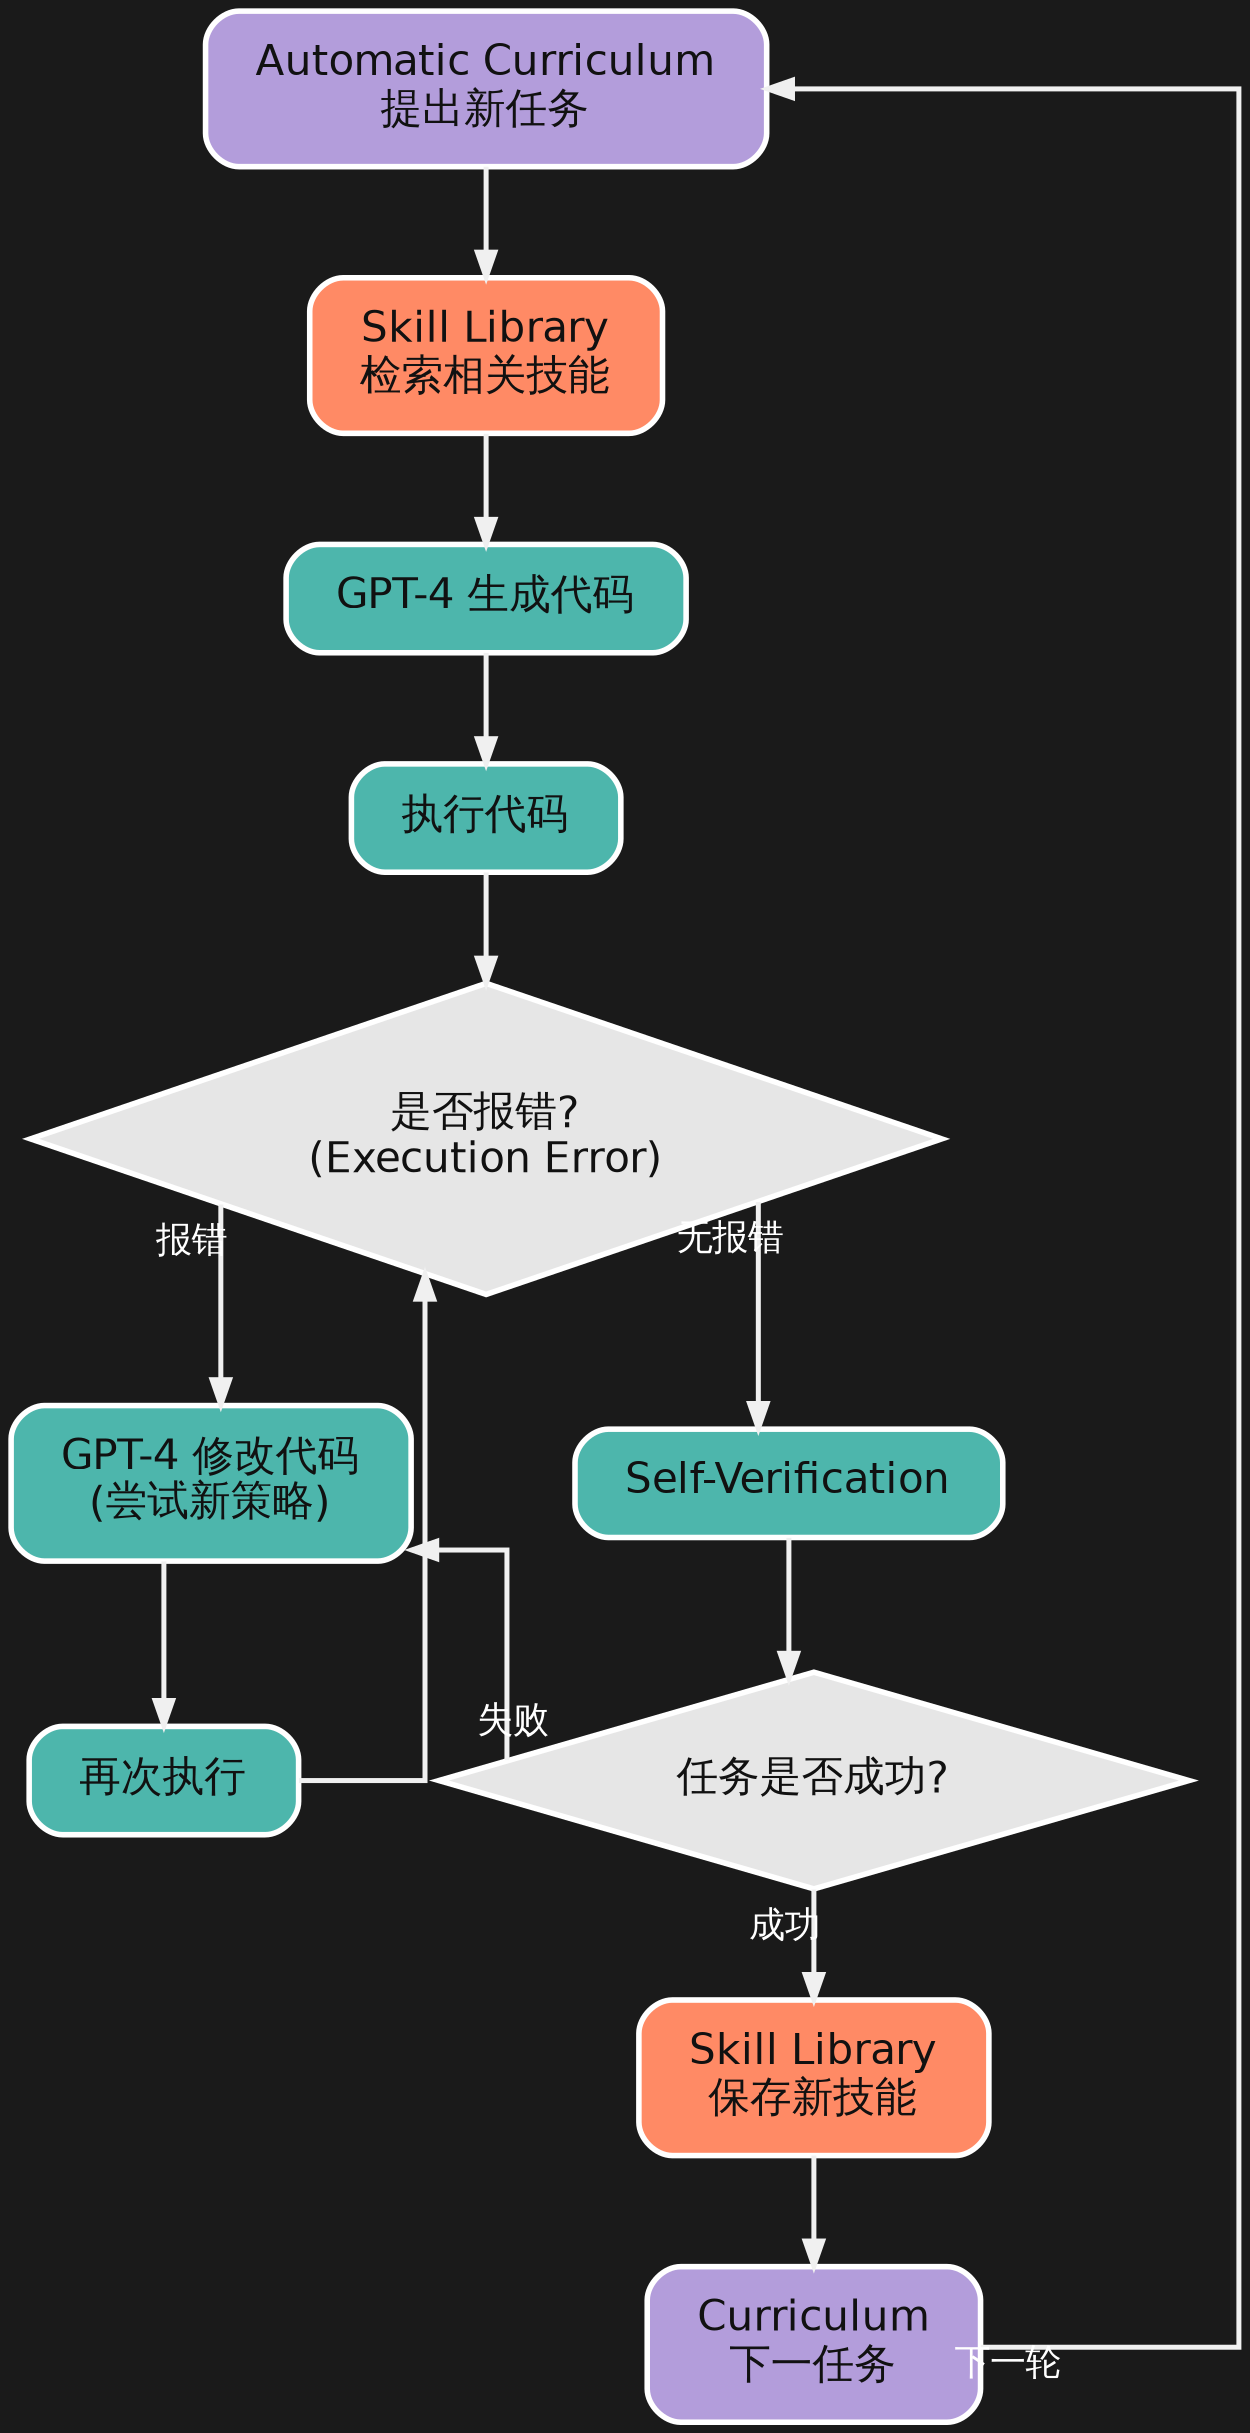
- 生成任务 → 检索相关 Skill → GPT-4 生成代码
- 执行代码
- Execution Error → 修改代码 → 重新执行
- 执行成功 → Self-Verification
- 验证成功 → 保存 Skill → 生成下一任务
- 验证失败 → 根据 Critique 修改代码 → 重新执行
因此,Voyager 的核心不是单纯的“让 LLM 玩 Minecraft”,而是建立一个能够持续探索、积累技能并逐渐变强的闭环。
由于 Voyager 的具体实现与 Minecraft 环境高度绑定,其代码本身并不具有通用性,因此这里主要学习它背后的系统设计思想和核心机制。
2. Voyager 的三个核心组成部分
Voyager 由三个核心组件组成:
| 组件 | 作用 | 核心问题 |
|---|---|---|
| Automatic Curriculum | 自动提出下一个探索目标 | 下一步做什么? |
| Skill Library | 保存已经学会的可复用技能 | 已经学会了什么? |
| Iterative Prompting Mechanism | 生成、执行和不断改进代码 | 怎么完成当前任务? |
三者形成一个循环:
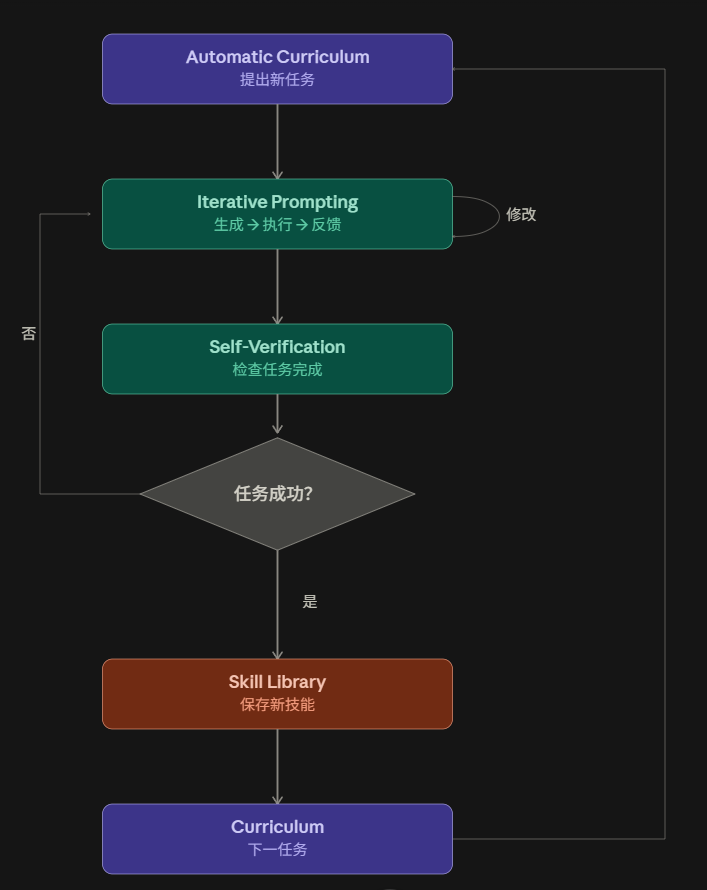
可以简单理解为:
- Automatic Curriculum:决定 做什么
- Iterative Prompting:决定 怎么做
- Skill Library:保存 学会了什么
3. Automatic Curriculum —— 自动课程
3.1 它解决什么问题?
Minecraft 是开放世界,不存在固定的任务清单,例如:
挖木 → 做木镐 → 挖石 → 做石镐 → 挖铁
Voyager 需要自主生成任务序列。
其总体目标是:
尽可能多地发现游戏中的多样化元素。
同时,下一项任务不能太难,否则当前 Agent 可能没有足够的资源或技能完成任务。
因此,Automatic Curriculum 的核心就是:
根据 Agent 当前的状态和探索进度,自动决定下一步应该做什么。
4. Automatic Curriculum 的输入
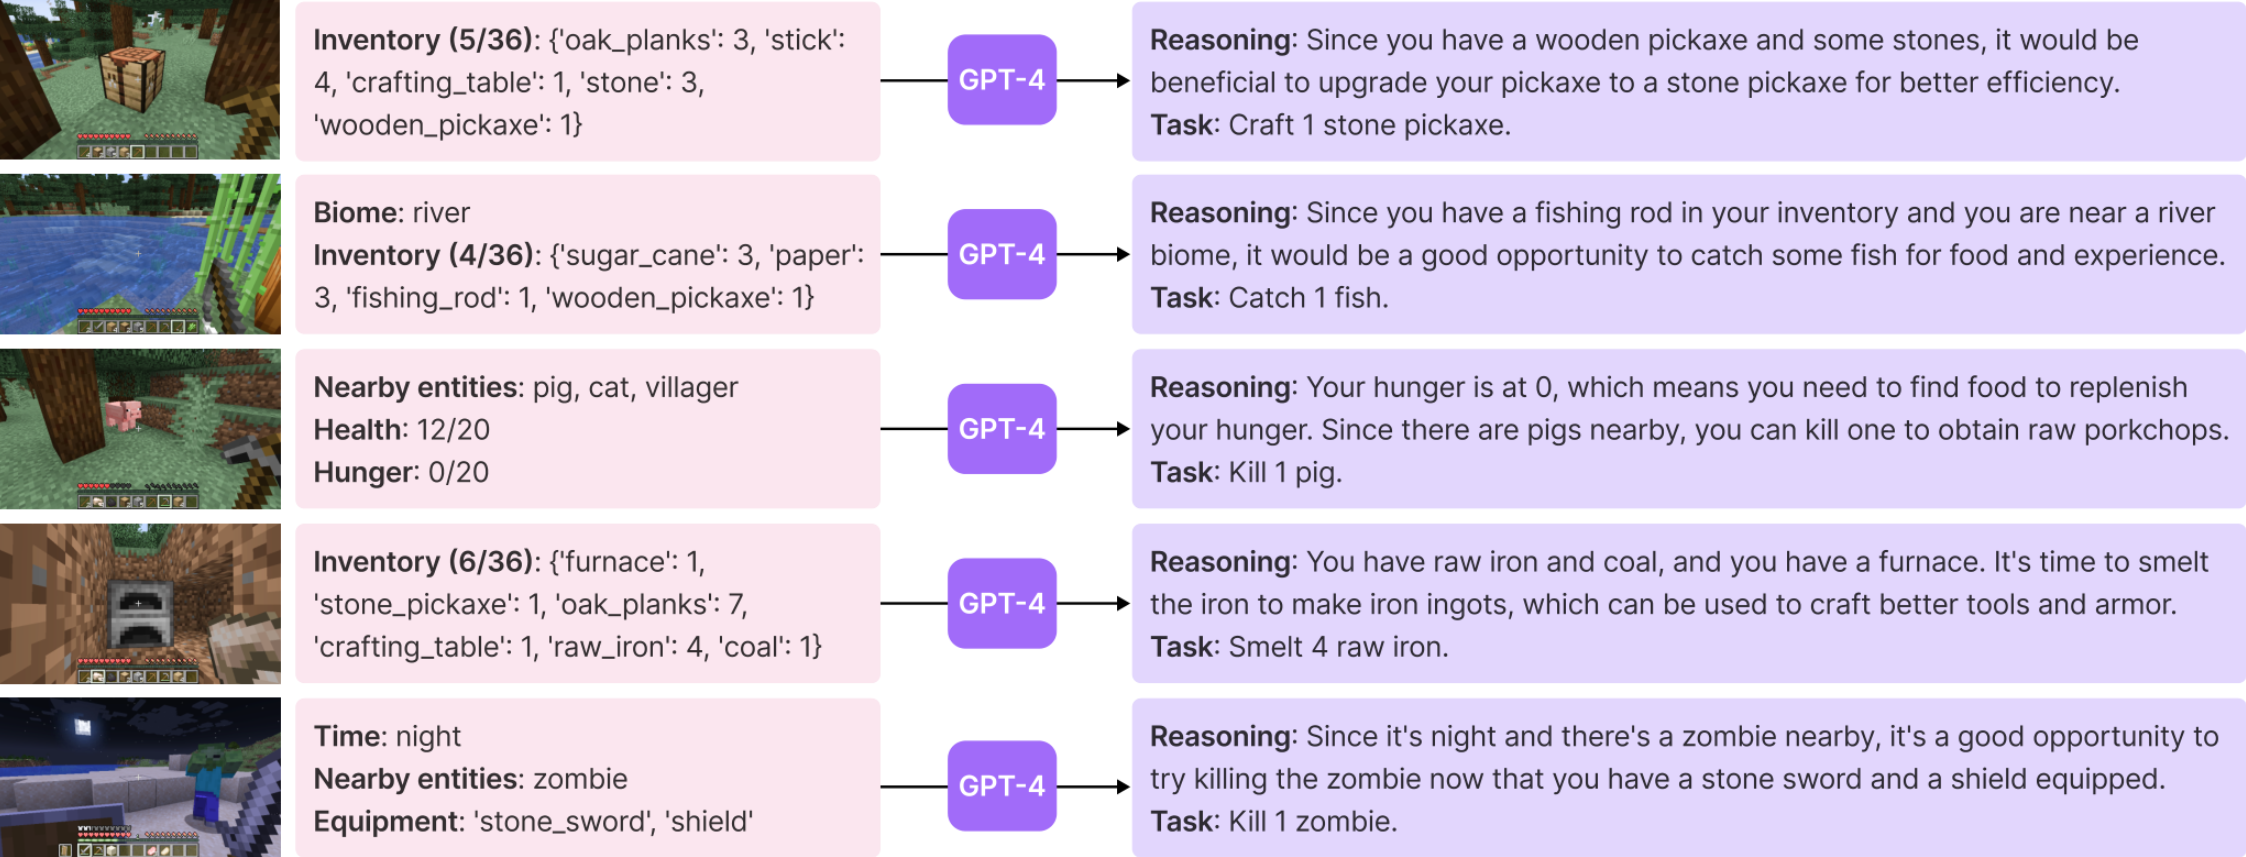
GPT-4 在决定下一个任务时,并不是凭空生成任务,而是会获得多方面的信息。
Automatic Curriculum 在生成下一任务时,LLM 的 Prompt 需要以下输入信息:
- Directives:总体探索目标和约束
- Current State:智能体当前 Minecraft 状态
- Completed / Failed Tasks:之前完成和失败的任务
- Additional Context:由 GPT-3.5 根据当前状态和探索进度进行 self-ask 得到的问答结果
4.1 Directives —— 总体目标与约束
首先告诉 GPT-4 Voyager 的总体目标。
例如:
“My ultimate goal is to discover as many diverse things as possible.”
同时还会加入约束:
“The next task should not be too hard since I may not have the necessary resources or have learned enough skills to complete it yet.”
也就是说:
任务既要推动探索,又不能一下子难到当前智能体无法完成。
4.2 Agent Current State —— 当前状态
Voyager 会把当前 Minecraft 状态提供给 GPT-4,例如:
- inventory:背包
- equipment:装备
- nearby blocks:附近方块
- nearby entities:附近实体
- biome:生物群系
- time:游戏时间
- health:生命值
- hunger:饥饿值
- position:当前位置
例如 GPT-4 可以知道:
1 | Inventory: |
这样 GPT-4 就能够判断:
当前已经有什么?当前还缺什么?下一步适合做什么?
从而生成一个与当前状态匹配的任务。
4.3 Previously Completed / Failed Tasks
Voyager 还会告诉 GPT-4:
- 已经完成过什么任务
- 哪些任务失败过
例如:
1 | Completed: |
这些信息能够反映 Voyager 当前的探索进度和能力边界(capabilities frontier)。
例如:
木头和石头相关能力已经掌握,但是铁相关能力还没有完全掌握。
因此,GPT-4 可以根据之前的执行情况生成更加合适的后续任务,而不是盲目提出一个当前难以完成的高级任务。
4.4 GPT-3.5 Self-Ask
Voyager 还会利用 GPT-3.5 根据当前状态和探索进度:
- 自己提出问题
- 自己回答问题
例如可以围绕当前状态产生一些辅助性问题:
1 | What resources are currently available? |
这些问答结果可以作为额外上下文,帮助后续的任务生成。
这里使用 GPT-3.5 而不是 GPT-4,主要是为了降低成本。
5. Skill Library —— 技能库
Automatic Curriculum 解决:下一步做什么?
Skill Library 解决:以前学会的东西怎么保存和复用?
这是 Voyager 非常重要的一部分。
5.1 Skill 是什么?
Voyager 并不是简单地把“我会做石镐”保存成一句自然语言描述,而是把技能表示为:可执行代码(executable code)。
例如:
1 | craftStoneShovel() |
或者:
1 | combatZombieWithSword() |
因此,一个 Skill 本质上是:
能够完成某个具体任务的一段可执行程序。
Skill 可以进一步组合:
1 | collectWood() |
后面的复杂任务可以直接调用之前已经学会的 Skill,而不需要每次都从零开始。
论文中的:
skills scaffold temporally extended actions
其中 scaffold 可以理解为:
为更复杂的行为提供基础和支撑。
5.2 Skill 的存储结构
一份 Skill 主要涉及 4 类持久化存储:
1 | U.f_mkdir(f"{ckpt_dir}/skill/code") # 保存 .js 完整代码 |
对应关系:
code/:保存program_code,即 LLM 生成并执行验证通过的完整 JS 函数代码description/:保存 LLM 根据代码和函数名生成的自然语言描述vectordb/:保存description的 embedding 向量,用于语义检索skills.json:保存self.skills,记录program_name → code + description的映射
skills.json 主要用于保存 Skill
的代码和描述映射:
1 | { |
5.3 添加
Skill:add_new_skill
主要流程:
- 过滤:排除不值得复用的一次性任务,例如往箱子存杂物。
- 生成描述:调用
generate_skill_description,让 LLM 根据代码和函数名生成skill_description。 - 处理重名:如果
program_name已存在,则删除 Vector DB 中旧条目;旧代码文件可以改名为xxxV2.js留档,但self.skills只保留最新版本。 - 更新:将新的 description 加入 Vector DB,并更新
self.skills[program_name]。 - 持久化:代码、描述、
skills.json和 Vector DB 分别保存。
5.4 检索
Skill:retrieve_skills
query是当前任务的自然语言描述。k = min(库中现有技能数, retrieval_top_k),避免库中 Skill 较少时出错。similarity_search_with_score(query, k=k):将query转成 embedding,与 Skill Description 的 embedding 计算相似度,取 Top-K。- 根据
doc.metadata["name"]反查self.skills[name]["code"],返回真正的 Skill Code。
6. GPT-4 生成 Skill 所需 的输入
Skill Library 生成新 Skill 时,LLM Prompt 需要以下输入信息:
- 代码生成规范(Guidelines):要求 Skill 具有通用性和可复用性,便于后续组合成更复杂的 Skill。
- Primitive APIs + 相关已有 Skill:提供最基础的执行操作 API,以及从 Skill Library 中检索出的相关已有 Skill,供 GPT-4 复用和组合。
- 上一轮代码及执行反馈:包括上一轮生成的代码、环境反馈、执行错误和 Critique,用于迭代改进。
- 当前环境状态(Current State):包括背包、装备、附近方块/实体、生物群系、时间、生命值、饥饿值和位置。
- Chain-of-Thought:要求 GPT-4 在生成代码前进行任务分析和步骤规划。
这样和前面的:
6.1 Code Generation Guidelines
首先要求 GPT-4 生成的 Skill 具有通用性、可复用性和模块化特征,因为生成的 Skill 后续还会被其他更复杂的 Skill 调用。
也就是说,不应该只针对当前任务编写一次性的代码,而应该尽可能将其设计成可以被后续任务重复调用的技能。
例如,Prompt 可以要求:
The code should be generic, reusable, and modular, as it may be reused by other skills in the future. Avoid writing code that only works for the current specific situation.
6.2 Control Primitive APIs + Relevant Skills
6.2.1 Control Primitive APIs
Voyager 提供底层控制 API。
例如可以理解为:
1 | 移动 |
这些属于比较底层的 control primitives。
GPT-4 可以利用这些 API 编写更高级的 Skill。
6.2.2 Relevant Skills
Voyager 会从 Skill Library 中检索与当前任务相关的技能,并把它们放进 GPT-4 的 prompt。
例如当前任务:
制作铁胸甲
GPT-4 可能已经拥有:
1 | collectWood() |
那么 GPT-4 就可以直接组合这些已有技能,而不是重新学习所有底层操作。
这实际上形成了:
Skill Library → In-context Learning → 更复杂的新 Skill
6.3 Previous Code + Feedback + Errors + Critique
如果上一轮代码失败了,GPT-4 还会看到:
- 上一轮生成的代码
- 环境反馈
- execution error
- critique
然后根据这些信息进行修改。
因此技能生成并不是:
GPT-4 → 一次生成 → 完成
而是:
GPT-4 生成代码 → 执行 → 发现问题 → 修改代码 → 再次执行
6.4 Current State
同样会提供 Minecraft 当前状态:
1 | Inventory |
因为代码必须适应当前真实环境。
6.5 Chain-of-Thought Prompting
在生成代码之前,让 GPT-4 先进行任务分析和推理。
可以简单理解为:
任务 → 分析所需资源 → 分析可使用的 API / Skill → 规划执行步骤 → 生成代码
因此,并不是直接要求:
“Write code.”
而是让 GPT-4:
先思考如何完成任务,再生成代码。
这里的 CoT 更接近于在同一次 LLM 调用中先进行推理,再生成代码,而不是先输出一个完整的分步骤计划,再针对每一步单独调用 LLM 生成代码并执行。
因此:有 CoT ≠ 有显式的 Plan-then-Act Pipeline
CoT 主要用于提升单次代码生成的质量,例如让 GPT-4 在生成代码前先分析需要哪些资源、应该使用哪些 Primitive APIs、哪些已有 Skill,以及任务的执行步骤。
例如,Prompt 可以要求 GPT-4:
Your task is to write a program to accomplish the following task.
Before writing the code, think about: 1. What resources are required? 2. What skills or APIs can be reused? 3. What steps are needed to accomplish the task? 4. How should these steps be implemented?
Then write the code to accomplish the task.
6.6 源码prompt
voyager/prompts/action_template.txt
1 | You are a helpful assistant that writes Mineflayer javascript code to complete any Minecraft task specified by me. |
1. Primitive APIs + 已有 Skill
{programs}:提供已有的 Mineflayer API 示例和已学习的 Skill。- 规则 2 中显式列出的函数,例如
mineBlock等,可直接调用。
2. 上一轮代码与执行反馈 每轮提供上一轮执行结果,包括:
Code from the last roundExecution errorChat logCritique
用于分析上一轮代码的问题,并据此调整下一轮实现。
3. 当前环境状态 每轮提供 Minecraft Agent 的实时状态,包括:
BiomeTimeNearby blocksNearby entitiesHealthHungerPositionEquipmentInventoryChests
其中 Inventory 是任务规划和完成度判断的重要依据,最终任务是否完成也会结合最终 Inventory 进行检查。
4. 推理与任务规划要求 Prompt 要求 Agent 在生成代码前进行以下分析:
Explain(如适用):检查当前计划是否存在遗漏,并分析代码为什么未能完成任务,以及
Chat log和Execution error反映出的问题。Plan:给出完成任务的分步计划,并结合当前环境状态,尤其是
Inventory,确定下一步需要执行的操作。
5. 代码生成规范 遵循 Prompt 后半部分的 规则 1~11,并满足输出格式中对代码的通用性要求,最终生成可执行的 Mineflayer JavaScript 代码。
{response_format} 内容如下
1 | Explain: ... |
7. 迭代式提示机制
迭代式提示机制是 Voyager 的核心代码生成与执行框架。其基本流程为:GPT-4 生成代码后立即执行,系统根据执行结果和任务完成状态,决定是否进行下一轮修改。完整循环如下:
生成代码 → 执行 → 获取反馈 → 修改代码 → 再次执行
该迭代将持续进行,直至任务成功完成或达到预设的最大尝试次数。
执行结果主要对应以下三类反馈情形:
- 环境反馈:代码运行正常,但 Minecraft 环境反馈任务前置条件不满足,需调整行动策略。
- 执行错误:代码本身引发异常(如语法错误、API 调用失败),需修正程序逻辑。
- 自我验证:代码无报错,但任务目标实际未达成,需分析失败原因并提出改进方案。
7.1 环境反馈(代码执行正常,但环境条件不满足)
代码本身运行无误,但 Minecraft 环境反馈任务前置条件未能满足。
例如,环境返回:
“无法合成铁胸甲,因为还缺少 7 个铁锭。”
此反馈向 GPT-4 传递了明确的语义信息:
text
1 | 任务目标:合成铁胸甲 |
据此,GPT-4 可针对性地调整策略(如先采集更多铁锭),而非盲目重试。
本质:环境反馈是 Minecraft 世界向大语言模型传递的状态信息,用于指导下一步行动决策。
7.2 执行错误(代码运行异常)
代码在执行器层面抛出异常,包括但不限于:
- 语法错误(SyntaxError)
- 非法操作(Invalid Operation)
- API 调用异常(API Error)
此类错误直接暴露了代码本身的缺陷,能够帮助 GPT-4 快速定位并修正程序逻辑中的具体问题。
7.3 自我验证(代码执行正常,但任务目标未达成)
代码运行虽未报错,却并不代表任务真正完成。
例如,任务要求“获得一个铁胸甲”,执行全程无 Python 异常,但最终状态为:
1 | 铁胸甲数量 = 0 |
此时,任务仍然失败。
为此,Voyager 引入了一个独立的 GPT-4 智能体 负责自我验证(Self-Verification)。该智能体以当前任务和智能体状态为输入,输出任务是否完成(Yes / No)。当判定失败时,它还会进一步提供:
- 批评意见(Critique):解释为什么失败;
- 改进建议(Suggestion):指出下一步应如何调整。
因此,自我验证提供的并非简单的“成功/失败”二值信号,而是包含失败原因和修正方向的高质量语义反馈,可显著提升后续迭代的效率和准确性。
8. 三个组件如何形成完整闭环?
最后复习一下流程
9. Voyager 的亮点
Voyager 最值得关注的亮点,是其提出的 “用代码作为 Agent 的动作空间(Code as Action Space)” 这一核心思想。
传统 LLM Agent 通常让模型输出 JSON、文本指令或预定义的 API 调用作为动作,而 Voyager 则让 GPT-4 直接生成可执行的 JavaScript 代码,通过代码调用 Minecraft 环境中的 API 来完成复杂、连续的操作。
这种方式的优势在于:代码天然可以表达多步、组合式和具有时间跨度的动作。Agent 不需要每一步都重新生成一个简单动作,而是可以生成一段程序,一次完成多个连续操作,并根据执行结果不断修改和扩展代码。
9.1 从 Voyager 到 CodeAct
Voyager 最初是在 Minecraft 开放世界环境中验证这一思想。
之后,CodeAct 将这一思想进一步抽象为一种通用的 LLM Agent 动作范式:
不再限制 Agent 输出固定格式的 JSON / 文本动作,而是让 LLM 直接生成可执行代码作为动作。
CodeAct 将 Agent 的动作空间统一为可执行的 Python 代码,并通过 Python 解释器执行这些代码。Agent 可以根据执行结果获得反馈,在后续交互中继续修正代码、组合已有操作或生成新的动作。
9.2 Voyager 的 Skill Library
除了 Code as Action Space,Voyager 的另一个重要亮点是 Skill Library(技能库)。
Voyager 并不是让 Agent 每次遇到任务都从零生成代码,而是会将已经验证有效的技能保存下来,并在后续任务中进行检索和复用。每个 Skill 本质上是一段可以执行的 Mineflayer JavaScript 程序,用于完成某个具有明确功能的任务,例如获取资源、制作物品或执行一系列连续操作。
Skill Library 主要解决的是 “已有能力如何积累和复用” 的问题:
- Skill 生成:GPT-4 根据当前任务、Agent 状态以及已有程序等信息生成新的可执行代码。
- Skill 执行与验证:生成的代码在 Minecraft 环境中执行,并根据执行结果判断其是否有效。
- Skill 存储:验证成功的代码及其描述被保存到 Skill Library 中。
- Skill 检索:面对新任务时,根据任务语义从已有 Skill 中检索相关技能,并将其作为后续代码生成的参考。
- Skill 组合:Agent 可以调用或组合多个已有 Skill,完成比单个 Skill 更复杂的任务。
因此,Skill Library 与 Code as Action Space 是相互配合的:
Code as Action Space 解决“Agent 如何表达和执行复杂动作”,而 Skill Library 解决“Agent 如何积累、检索和复用已经学会的动作”。
这使 Voyager 不仅能够在当前任务中生成代码,还能够随着探索过程持续积累可复用的程序化技能,从而逐渐形成能力库。
9.3 OpenHands:代码 Agent 的实际落地
这一思路后来被 OpenHands(原 OpenDevin) 等开源 Coding Agent 框架进一步采用和发展。
OpenHands 将 Agent 的动作空间扩展到真实的软件开发环境,使 Agent 能够通过代码、Shell、文件操作等方式与开发环境交互,完成编程、调试、运行程序等任务。