从零开始的LLM 10. mem0原理及API使用
前言
本文将介绍 mem0 的原理以及简单的agent制作。
经过前面的学习,我们已经系统地完成了大语言模型(LLM)的基础部分,主要参考了以下资料:
- 《动手学深度学习》
- 《蘑菇书》
- 《Happy-LLM》
- 《Hello-Agents》
- 《all-in-rag》
到这里,可以认为已经具备了继续深入学习 Agent 的基础能力。
接下来的内容将不再像之前那样按照固定课程循序渐进,而是更多围绕当前 Agent 领域的研究方向展开。学习内容既会涉及工程实践(如各种 Agent 框架、工作流、记忆系统等),也会涉及算法与模型层面的探索(如多模态、持续学习等)。
- Generative Agents
- Letta
- A-MEM
- Voyager
这条路线主要围绕 Agent 的持续学习(Continual Learning) 展开,也是我目前最感兴趣的方向:如何让一个 Agent 在长期运行过程中不断积累经验、提升能力,而不是每次都从零开始。
目前来看,大致有两种思路:
- 不修改模型本身。 仅通过 Prompt、记忆系统(Memory)、RAG、工具调用等机制,使 Agent 能够不断积累知识和经验,实现能力的持续增长。
- 修改模型本身。 基于 Agent 长期运行过程中积累的对话、笔记和总结等数据,在合适的时机对模型进行持续训练(Continual Fine-tuning),使模型真正将这些经验内化,而不仅仅依赖外部记忆。
由于这一阶段更多是阅读论文、分析开源项目、验证实验以及整理个人理解,而不是单纯跟着教程学习,因此资料收集、实验和整理都会比之前花费更多时间。
相比之前学习的 A-MEM,mem0 在实际应用中的知名度和社区活跃度都更高,整体也更加成熟。本章节会花一些时间先了解 mem0 的核心原理,然后再基于 mem0 实现一个简单的 Agent。不过mem0的v2和v3 pipeline版本实现有非常大的不同,我们先讲论文中v2的实现,再分析v3的不同。
和之前的 A-MEM 类似,这次我们同样会把重点放在“记忆系统是如何融入 Agent”这件事情上。不过这次不再使用 LangGraph,整体实现会更加简单,也更方便我们直接理解 mem0 的使用方式。
1. Mem0 原理
论文地址:https://arxiv.org/abs/2504.19413
Mem0 的核心目标是:从对话中提取长期有价值的信息,并将这些信息持续写入、更新到长期记忆中,同时支持后续检索。
从整体流程来看,可以将 Mem0 理解为三个主要部分:
- Extraction:从对话中提取 candidate memories
- Update:将 candidate memories 与已有 memories 进行比较并更新
- Retrieval:从长期记忆中检索与当前 query 相关的信息
1.1 提取阶段(Extraction Phase)
Mem0 的记忆提取通常以一对消息作为当前输入,即:
- 一条 user message
- 一条 assistant response
可以表示为:
\[ (m_{t-1},m_t) \]
其中,\(m_t\) 表示当前消息,\(m_{t-1}\) 表示紧邻当前消息的上一条消息。
但是,仅仅将当前消息对交给 LLM 并不足以判断哪些信息值得长期保存。
因此,Mem0 会进一步提供一些历史上下文信息,共同构成 extraction 的输入。
1.1.1 当前消息对(Current Message Pair)
当前消息对:
\[ (m_{t-1},m_t) \]
通常可以理解为:
1 | User: 我最近开始学习 LangGraph。 |
这部分是当前 extraction 最重要的信息来源,因为新的长期记忆通常与当前对话内容直接相关。
1.1.2 对话总结(Conversation Summary / Summary Context)
如果每次提取记忆时,都把整个 conversation history 放进 LLM prompt,那么随着对话不断增长,prompt 会越来越长。
因此,Mem0 会维护一种对历史对话的压缩表示,用于在不保留全部原始消息的情况下,为 LLM 提供更长期的上下文。
例如,一个较长的 conversation 可能包含:
1 | 第1轮 |
经过 summary 后,可以形成类似:
1 | 用户 Bob 是一名程序员,主要使用 Python, |
这个 summary 的作用并不是直接充当最终 memory,而是作为历史上下文压缩信息,帮助 extraction LLM 理解当前对话所处的背景。
因此,可以将它理解为:
Summary 解决的是“历史太长,无法全部放入 extraction prompt”的问题。
需要注意的是,S 是针对当前 conversation history 生成的总结信息,其作用是压缩当前 conversation 中的历史内容。因此,当开始一个新的 conversation 时,通常会对应新的 conversation context / summary,而不会直接继承上一段 conversation 的 S。
换句话说,S 主要用于帮助 extraction 阶段理解当前 conversation 的历史背景,而不是一个跨 conversation 永久保存的长期 memory。
1.1.3 最近的历史消息(Recent Messages)
除了 summary 之外,Mem0 还可以提供最近的一部分历史消息:
\[ {m_{t-n},m_{t-n+1},...,m_{t-2}} \]
这些消息用于保留比 summary 更具体、更细粒度的近期上下文。
例如:
1 | 最近历史消息: |
这些信息可以帮助 LLM 判断当前消息中的内容是否与最近的对话有关。
1.1.4 Extraction Prompt
最终,Mem0 会将这些上下文共同提供给 LLM:
\[ P= \left( S, {m_{t-n},...,m_{t-2}}, (m_{t-1},m_t) \right) \]
其中:
- \(S\):历史 conversation 的 summary/context
- \({m_{t-n},...,m_{t-2}}\):最近的一部分历史消息
- \((m_{t-1},m_t)\):当前消息对
然后通过 LLM:
\[ \phi(P)\rightarrow\Omega \]
提取出一组值得考虑保存的候选记忆: \[ \Omega={\omega_1,\omega_2,...,\omega_n} \] 这些 \(\omega_i\) 可以称为:
candidate facts / candidate memories
例如当前对话:
1 | User: |
LLM 可能提取:
1 | Bob 是一名程序员 |
此时这些内容还只是候选记忆,并不意味着已经直接写入长期记忆数据库。
因此:
Extraction 的任务是“发现可能值得保存的记忆”,而不是直接决定数据库最终应该保存什么。
最终是否 ADD、UPDATE、DELETE 或 NOOP,要在下一阶段决定。
1.2 更新阶段(Update Phase)
Extraction 得到: \[ \Omega={\omega_1,\omega_2,...,\omega_n} \] 之后,Mem0 需要判断:
这些新的 candidate memories 与数据库中已有的 memories 是什么关系?
因为不能简单地把每一次对话产生的新信息全部 ADD
到数据库。
否则:
1 | User: 我使用 Python。 |
最终数据库可能出现大量语义重复的 memory。
因此,对于每一个 candidate fact,Mem0 会首先从已有 memory 中检索语义上最相关的 memories(向量相似检索)。
可以抽象为:
1 | candidate fact |
对于每一个 candidate fact,Mem0 会将其与检索到的相关 existing memories 一起交给 LLM,由 LLM 判断应该对长期记忆执行哪一种操作:
| 操作 | 含义 |
|---|---|
| ADD | 数据库中不存在语义等价的 memory,因此创建新的 memory |
| UPDATE | 已存在相关 memory,但新的信息可以对其进行补充或完善,因此更新已有 memory |
| DELETE | 新信息与已有 memory 发生冲突,使原 memory 失效,因此删除或标记其为无效 |
| NOOP | 新信息不会对现有 knowledge base 产生实际变化,因此不做任何修改 |
1.3 Mem0 Graph Memory
前面的 Extraction + Update 主要解决的是:
从对话中提取长期记忆,并判断这些记忆应该如何写入或修改。
在此基础上,Mem0 还提供 Graph Memory,用于将记忆中的实体(Entity)及其关系(Relationship)结构化组织起来。
也就是说,普通 Memory 主要关注:
1 | “Bob 正在学习 LangGraph” |
而 Graph Memory 会进一步将它结构化为:
1 | Bob ──learns──> LangGraph |
因此,Graph Memory 的核心就是:
将记忆中的信息表示成由 Node 和 Edge 构成的知识图谱,从而利用实体之间的关系进行存储、更新和检索。
1.3.1 Graph 的基本结构
Mem0 的 Graph Memory 可以抽象表示为: \[ G=(V,E,L) \] 其中:
- \(V\):Nodes,表示实体(Entities)
- \(E\):Edges,表示实体之间的关系(Relationships)
- \(L\):Labels,表示实体的语义类型等标签信息
1.3.2 Node(实体节点)
Node 对应 Graph 中的一个
Entity,例如:Bob、Python、LangGraph、Google
每个 Node 主要包含:
- Entity Type:实体类型,例如
Bob → Person、Google → Organization - Embedding Vector:实体的向量表示,用于语义匹配和检索
- Metadata:实体的其他元数据,例如创建时间等
因此,一个 Node 可以抽象表示为:
1 | v=(entity_type, embedding, metadata) |
1.3.3 Relationship(关系)
在 Graph 中,Relationship 对应连接两个 Node 的 Edge,用于表示两个 Entity 之间存在的语义关系。
一个 Relationship 可以表示为: \[ (v_s,r,v_d) \] 其中:
- \(v_s\):source node,即关系的起点
- \(r\):relationship,即两个实体之间的关系
- \(v_d\):destination node,即关系的终点
例如: \[ (Bob,\ learns,\ LangGraph) \] 其中:
Bob是 source entitylearns是 relationshipLangGraph是 destination entity
在构建 Relationship 时,Mem0 会将关系转换成文本形式,例如:
1 | Bob learns LangGraph |
并对该文本进行 embedding,得到关系的向量表示,用于后续的关系语义检索。
Relationship 不仅记录了两个实体之间是什么关系,还具有对应的文本表示和向量表示,从而可以参与后续的语义检索。
1.3.4 Graph Memory 的构建
当新的 memory 被写入 Graph Memory 时,需要将其进一步结构化为实体和关系。
整体可以理解为两个步骤。
Step 1:Entity Extraction
首先从新的文本 memory 中提取实体:
1 | Alice works at Google and lives in San Francisco. |
可能提取:
1 | Alice → Person |
这些实体成为 graph 中的候选 nodes。
Step 2:Relationship Extraction
然后从这些实体之间提取关系:
1 | (Alice, works_at, Google) |
这里有一个非常重要的点:
关系主要是在当前这次新提取出来的 entities 之间建立的。
也就是说,并不是把整个知识图谱中的所有实体两两组合,再让 LLM 判断关系。
Step 3:判断Entity 是否已经存在
系统首先需要判断:
1 | Alice 是否已经存在? |
根据检查结果,可能出现:
1 | 两个 entity 都不存在 |
因此,entity matching / existence checking 是避免知识图谱中产生重复节点的重要步骤。
Relationship Conflict Detection
当新的 relationship 到来时,还需要考虑它是否与已有 relationship 冲突。Graph Memory 会进行 conflict detection,并由 LLM-based resolver 判断已有关系是否已经过时。
过时的关系不一定被物理删除,而可以被标记为
obsolete/invalid,从而保留历史信息。
1.4 Mem0 的记忆检索(Retrieval)
当用户提出新的 query 时,Mem0 需要从长期 memory 中找到与当前问题最相关的信息。
Graph Memory 中采用的是一种双轨检索策略(dual retrieval strategy)。
可以简单理解为:
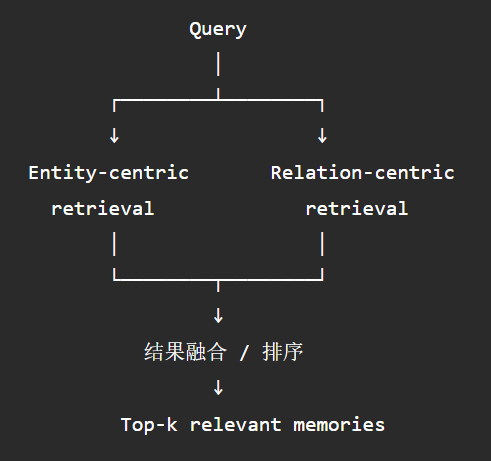
方法一:Entity-centric Retrieval
第一条路径是:
先从 query 中找到关键 Entity,再围绕这些 Entity 在图中进行扩展,最终找到与这些 Entity 相关的 Memories。
例如 query:
1 | Bob 最近在学习什么? |
首先从 query 中识别:
1 | Bob |
然后对 Bob 进行 entity-level 的语义检索,找到最相关的 entity。
之后进一步查看这些 entity 的邻居关系,例如:
1 | Bob |
最终,方法一返回的是与命中 Entity 及其一阶关系相关entity的 memories 构成的候选结果集合,并对结果进行去重和排序。
entity 会记录其来源的memory。所以一个entity里面可能来自多条不同memory,但是都全部作为结果返回。会由后续的LLM进行判断是否相关。
方法二:Relation-centric Retrieval
第二条路径则不依赖于先找到某个实体,而是直接从关系三元组出发。
例如知识图谱中存在:
1 | (Bob, uses, Python) |
每个 Relationship 在构建时都会形成对应的文本表示,例如:
1 | Bob uses Python |
系统将 query 转换为 embedding,并与 Graph 中各个 Relationship 的文本表示进行相似度匹配,得到与 query 最相关的 Top-k Relationships,并返回这些关系对应的文本描述。
双轨检索结果融合
两种检索方式会并行执行,分别得到 Entity-centric 和 Relation-centric 的检索结果。Mem0 将两路结果进行合并、去重并统一排序,最终选取得分最高的 Top-k 结果,作为提供给 Agent / LLM 的相关记忆上下文。
2. mem0 v3 pipeline 版本变动
目前通过 pip install mem0ai 安装的最新 mem0 版本,其默认
Pipeline 已经采用 v3;而 mem0 论文中介绍的 Pipeline
主要对应 v2。
v3 相比 v2 在记忆写入、图数据组织以及检索方式等方面都进行了较大调整。因此,本节单独介绍 v2 → v3 的主要变化。
其中最显著的变化是:v3 不再使用 Neo4j 等外部图数据库,而是直接移除了原有的 Graph Memory,并将部分图结构能力合并到 Memory Store 中。
2.1 整体架构:从 Memory + Graph 转向 Memory-centric
v2 的整体架构可以理解为两部分:Memory Store + Graph Memory
其中:
- Memory Store:负责存储和检索 memory;
- Graph Memory:负责提取 Entity,并通过 Entity-to-Entity 的关系构建 Knowledge Graph。
v3 则移除了独立的 Graph Memory,直接用同一个数据库存储memory和entity:
1 | Memory Store |
也就是说,v3 不再维护一个独立的 Entity-to-Entity Knowledge Graph,而是将 Entity 作为 Memory 的检索辅助结构。
同时,原有图数据库相关代码被大幅移除,包括
mem0/graphs/、graph_memory.py
等,Neo4j、Memgraph、Kuzu、Apache AGE、Neptune 等外部图数据库也不再属于
OSS SDK 的 Graph Memory 实现。
2.2 Memory 写入:从 “提取 + 更新” 变为 “增量累积”
这是 v3 在 Memory 层面最重要的变化之一。
v2:提取后再进行更新判断
v2 的写入过程大致需要经过两个阶段:
1 | 新消息 |
也就是说,v2 不仅负责发现新的 memory,还会主动判断新信息与已有 memory 之间的关系,并决定是否修改或删除已有 memory。
v3:提取后直接 ADD
v3 则将这一过程简化为:
1 | 新消息 |
主要变化包括:
- 使用
ADDITIVE_EXTRACTION_PROMPT直接提取新的 memory; - 不再执行 v2 中的
UPDATE / DELETE / NOOP判断; - 新旧 memory 不再通过覆盖的方式更新,而是通过
linked_memory_ids建立关联; - 摘要
S、recent messages 和当前 message pair 等输入信息的整体构造逻辑没有发生根本变化,主要变化集中在提取之后的 Memory 处理阶段。
因此,v3 的核心思想可以概括为:
不主动覆盖旧 memory,而是持续增加新的 memory,并通过关联关系表达新旧信息之间的联系。
例如:
1 | 旧 memory: |
这样做的好处是避免错误覆盖历史信息。例如,“喜欢 Python” → “喜欢 Rust”并不一定意味着前者是错误的,也可能只是用户偏好随时间发生了变化。
因此,v3 更倾向于保留完整历史信息,以支持时间维度上的推理。
其代价也很明显:Memory 不再通过 UPDATE / DELETE 自动控制规模,因此会持续累积,需要额外的删除和管理机制。
手动删除机制
v3 仍然提供显式的 Memory 管理能力,例如:
delete(memory_id):删除指定 memory;delete_all(filters):根据条件批量删除;delete_linked=True:删除某条 memory 时,同时沿linked_memory_ids关联链删除相关的旧 memory,避免被替代的旧 memory 在后续检索中重新出现。
2.3 Graph Memory:从 Entity → Entity 转变为 Entity → Memory
v3 最大的架构变化之一,是彻底取消了 v2 中基于 Knowledge Graph 的 Entity-to-Entity 关系组织方式。
v2:Entity → Entity
v2 中,Entity 是 Knowledge Graph 的节点。
例如:
1 | Alice ──works_at──> OpenAI |
通过这种带有语义关系类型的边:
1 | (source entity, relation, destination entity) |
将多个 Entity 连接起来,形成 Knowledge Graph。
因此,v2 的核心结构可以概括为:
1 | Entity → Entity |
v3:Entity → Memory
v3 不再维护这种 Entity-to-Entity 的显式关系,而是建立:
1 | Entity → Memory |
即:
Entity 不再作为一个具有复杂关系的 Knowledge Graph 节点,而主要作为 Memory 的检索索引。
例如:("python" 是作为例子的entity)
1 | Python → { |
这里的 Memory 就是包含或提取出该 Entity 的源记忆。
因此,v3 的结构更接近一个Entity → Memory 的倒排索引。
2.4 Entity 的提取与存储
v3 中,Entity 不再通过 Graph Memory 和 LLM 构建 Knowledge Graph,而是使用 spaCy 从每条 Memory 的文本中提取实体。
这里需要特别注意:
v3 的 Entity 提取不是通过 LLM 完成的,而是使用 spaCy 进行实体识别。
spaCy 主要用于从 Memory 中识别:
- 专有名词;
- 引用文本;
- 复合名词短语等实体信息。
提取出的 Entity 随后被存储到与 Memory Store 配合使用的独立 Entity collection 中:
1 | {collection}_entities |
并建立:
1 | Entity → Memory IDs |
的关联。
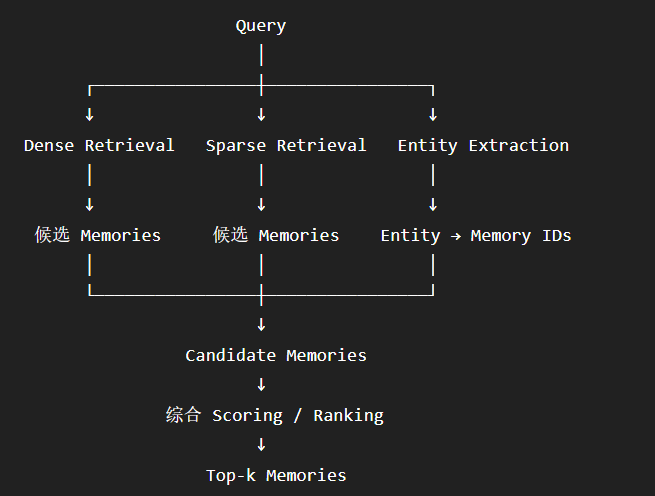
2.5 检索:Hybrid Search + Entity-aware Ranking
v3 的检索不再依赖 v2 的 Graph Retrieval,而是将多种检索方式进行融合,主要包括:
- 稠密检索(向量/语义):将 query 转换为 embedding,与 Memory Store 中已有 memory 的 embedding 进行相似度匹配,找到语义上最相关的 memory。
- 稀疏检索(关键词):利用 query 中的关键词、实体等信息,对 memory 文本进行关键词匹配,弥补纯向量检索可能遗漏的结果。
- Entity-aware Ranking:从 query 中提取关键 entity,并利用已经建立的 Entity → Memory 关联,找到与这些 entity 相关的 memory。
最终综合 semantic similarity、entity information 以及 metadata 等信息 对候选 memory 进行排序,选择排名靠前的结果。
2.6 v2 → v3 的核心变化总结
v2 → v3 的核心变化主要有以下四点:
- Memory 写入:从
ADD / UPDATE / DELETE / NOOP转变为以 ADD 为主的累积式记忆,通过linked_memory_ids关联新旧 memory。 - Graph Memory:移除 Neo4j 等外部图数据库,不再维护 Entity → Entity 的 Knowledge Graph,改为 Entity → Memory 的关联机制。
- Entity 提取:从原来的 Graph Memory 机制转变为使用 spaCy(非 LLM) 提取 Entity,并建立 Entity Index。
- Memory 检索:从原来的 Graph Retrieval 转变为 Hybrid Search + Entity-aware Ranking。
总体来说,v3 的设计目标是:
简化架构、降低延迟、减少旧记忆被错误覆盖的风险,同时保留 Entity 对 Memory 检索的辅助能力。
3. mem0 使用
首先安装 mem0ai:
1 | pip install mem0ai |
3.1 初始化 Memory
安装完成后,可以通过两种方式使用 Mem0。
方式一:MemoryClient——托管 Platform
API
1 | from mem0 import MemoryClient |
MemoryClient 本质上是一个 HTTP Client,实际的
memory extraction、update、storage 和 retrieval 都由
Mem0 官方云端完成。
方式二:Memory——开源自托管
1 | from mem0 import Memory |
这种方式运行在本地进程中,LLM、Embedding 模型以及向量数据库都由用户自行配置和管理。
3.2 配置
以 Ollama + Qdrant 为例:
1 | ollama_client = OllamaClient(host="http://localhost:11434") |
整个配置主要由三个部分组成:
1. llm:记忆抽取模型
负责 Mem0 pipeline 中的 Memory Extraction,即通过 LLM 从对话中提取 candidate memories。
在 v3 中,这里主要对应 ADDITIVE_EXTRACTION_PROMPT 的 LLM
调用,用于生成新的 memory。
2. embedder:Embedding
模型
负责将每条 memory 文本转换成向量,供后续的 Dense Retrieval 使用。
3.
vector_store:向量数据库
负责 memory 的向量存储和检索,这里使用 Qdrant。
其中:
collection_name:Qdrant 中存储 memory 的 collection 名称。embedding_model_dims:向量维度,必须与 Embedding 模型实际输出的维度一致,否则写入 Qdrant 时会出现维度不匹配。
例如可以通过 Ollama 确认实际维度:
1 | import ollama |
确认维度后,再将其设置到:
1 | "embedding_model_dims": 1024 |
最后根据配置实例化 Mem0:
1 | memory = Memory.from_config(config) |
3.3 构建一个带长期记忆的 Agent
一个最简单的 Mem0 Agent 可以按照以下流程工作:
用户输入 → 检索长期记忆 → 注入 Prompt → LLM 回答 → 将对话写入 Mem0
1 | USER_ID = "zusda" |
其中最关键的是两个操作:
1 | memory.search(...) |
负责检索已有的长期记忆;
1 | memory.add(...) |
负责将本轮对话交给 Mem0 的 memory pipeline 处理并写入记忆库。
因此,整个 Agent 可以简单理解为:
3.4 Main 函数
最后通过循环实现一个简单的命令行 Agent:
1 | if __name__ == "__main__": |
这样,一个最基本的 Mem0 + Ollama + Qdrant 长期记忆 Agent 就搭建完成了。
4. 其他
4.1 安装 Qdrant
如果使用 Docker 部署 Qdrant,首先拉取镜像:
1 | docker pull qdrant/qdrant |
然后启动 Qdrant 容器:
1 | docker run -p 6333:6333 -p 6334:6334 -v C:\Users\admin\qdrant_storage:/qdrant/storage qdrant/qdrant |
其中:
6333:Qdrant HTTP API 端口6334:Qdrant gRPC 端口-v:将宿主机目录挂载到容器中的/qdrant/storage,用于持久化数据。
例如:
1 | C:\Users\admin\qdrant_storage |
表示 Windows 本地的一个磁盘目录。Qdrant 的数据会通过目录映射保存到该位置。
如果不使用 -v 进行持久化,Qdrant
数据只保存在容器内部。删除容器后,容器中的数据也会随之丢失。